12
min di lettura
Strumenti di documentazione IA nelle lingue europee
Perché gli strumenti di documentazione IA hanno prestazioni diverse nelle lingue europee nell'assistenza primaria. Validazione linguistica, variazioni dialettali e sfide della codifica clinica spiegate
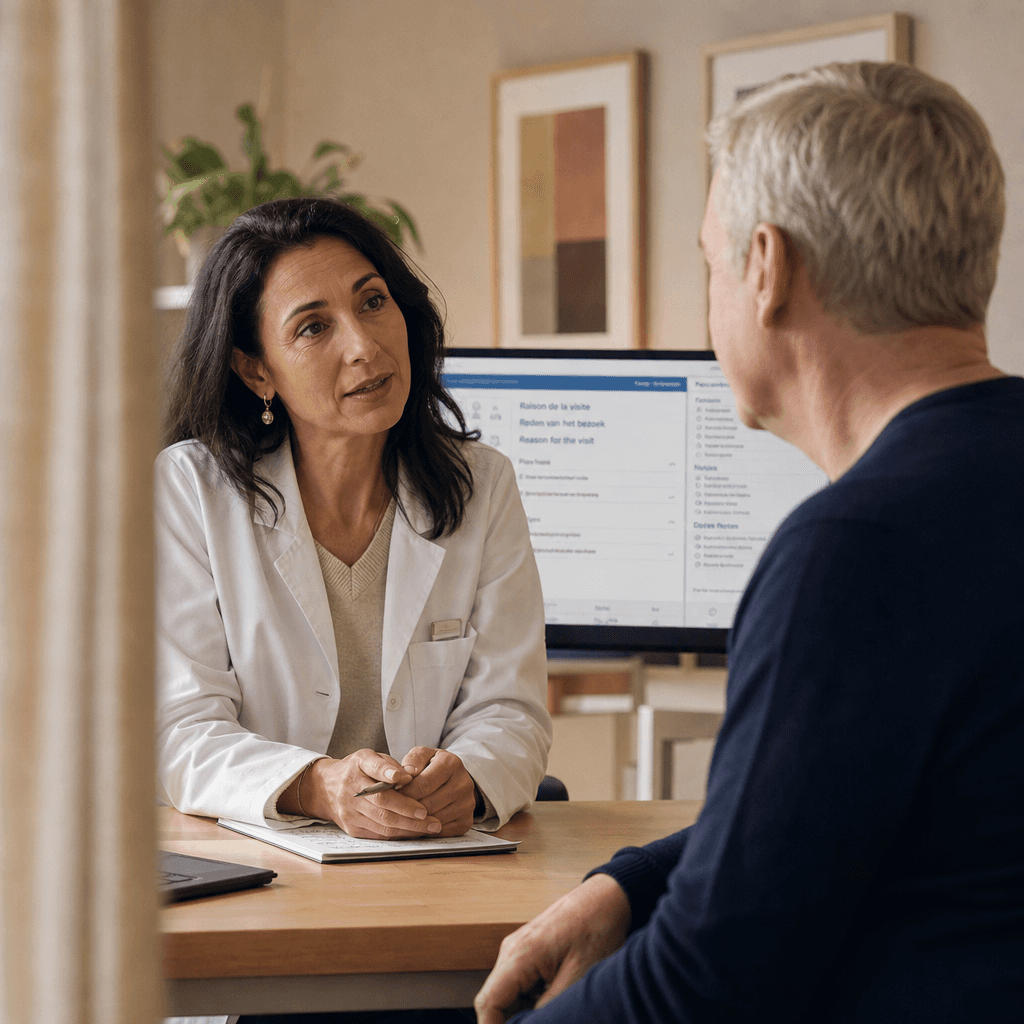
Gli strumenti di documentazione basati sull'intelligenza artificiale non sono stati progettati per la realtà linguistica dell'assistenza primaria europea. Un medico a Bruxelles documenta in olandese mentre visita un paziente arabofono. Un collega a Vienna passa dal tedesco standard al dialetto viennese a metà frase. Le lacune nelle prestazioni che ne derivano non sono semplici inconvenienti: rappresentano potenziali rischi per la sicurezza dei pazienti.
Come gli strumenti basati sull'intelligenza artificiale elaborano il linguaggio e dove falliscono
La maggior parte degli strumenti di documentazione combina due componenti distinte. La prima è il riconoscimento vocale automatico, che converte le parole pronunciate in testo. La seconda è un modello linguistico di grandi dimensioni, che trasforma quel testo in documentazione clinica strutturata. Gli errori si accumulano in entrambi gli strati. Se il riconoscimento vocale fraintende un termine clinico pronunciato con accento regionale, lo strato successivo riceve un input errato e può generare una nota dal suono plausibile ma clinicamente sbagliata.
I clinici che valutano questi strumenti dovrebbero quindi chiedersi non solo "supporta questa lingua?", ma anche "dove nella catena di elaborazione si inceppa e in che modo?".
Perché alcune lingue europee sono meglio supportate di altre
La ragione principale delle disparità è lo squilibrio nei dati di addestramento. I modelli vengono addestrati prevalentemente su dataset in lingua inglese. Quando un modello ha elaborato miliardi di documenti clinici in inglese ma solo milioni, o centinaia di migliaia, di testi equivalenti in olandese, rumeno o greco, le sue prestazioni in quelle lingue saranno strutturalmente più deboli. Una ricerca pubblicata su Scientific Reports nel 2025 ha documentato come fattori quali la ricchezza morfologica, la variazione sintattica e la diglossia influenzino i modelli linguistici di grandi dimensioni, con effetti particolarmente marcati nelle lingue sottorappresentate. La diglossia, cioè la coesistenza di due varietà della stessa lingua con funzioni sociali diverse, è diffusa in molte aree europee e crea difficoltà specifiche per i sistemi di trascrizione automatica.
In termini generali: l'inglese è la lingua meglio supportata, e di molto. Spagnolo, francese e tedesco hanno una rappresentanza ragionevole, sebbene con lacune nel vocabolario clinico. Olandese, portoghese e italiano hanno un supporto moderato, con lacune significative nella terminologia specialistica. Le lingue probabilmente più sottorappresentate, tra cui polacco, rumeno, greco, ceco, ungherese, finlandese, catalano, gallese e maltese, richiedono una verifica indipendente dell'accuratezza prima di qualsiasi implementazione.
Modalità di errore prevedibili per famiglia linguistica
Il tedesco e l'olandese fanno ampio uso di sostantivi composti. Un termine come Herzinsuffizienz deve essere riconosciuto come un'unica entità clinica corrispondente a "insufficienza cardiaca". Gli strumenti non addestrati su una quantità sufficiente di testo clinico in tedesco tendono a segmentare o a riconoscere erroneamente questi composti, con note che omettono o distorcono la diagnosi.
Le lingue romanze, francese, spagnolo, portoghese e italiano, assegnano un genere grammaticale alla terminologia medica, e il significato clinico può cambiare in presenza di errori di concordanza. La variazione regionale nel vocabolario è inoltre significativa: la stessa condizione può essere descritta con termini diversi in Francia rispetto al Belgio, o in Spagna rispetto all'America Latina. Una ricerca sulle note di assistenza primaria bilingui in spagnolo e catalano ha rilevato che il riconoscimento congiunto delle diagnosi e il loro collegamento ai codici ICD-10 in note bilingui non standard rappresenta un problema specifico e tutt'altro che banale.
Il polacco e il ceco sono morfologicamente complessi: i loro ampi sistemi flessionali fanno sì che un termine clinico possa apparire in sei o più forme all'interno di una singola consultazione. Un modello senza un'esposizione adeguata a questa variazione non riesce a riconoscere in modo coerente lo stesso concetto clinico nelle sue diverse forme. Le valutazioni multilingue dell'affidabilità dei modelli linguistici di grandi dimensioni in ambito sanitario identificano questa lacuna come una barriera critica all'adozione nella pratica reale. Vale la pena segnalare che il benchmark citato copre 15 lingue senza includere polacco, ceco o slovacco, il che significa che le prestazioni nelle lingue slave restano a tutt'oggi poco valutate.
Dialetti, accenti e code-switching
Anche all'interno di una singola lingua ufficialmente supportata, la variazione dialettale può ridurre sostanzialmente l'accuratezza. Uno strumento validato per l'olandese standard può avere prestazioni inferiori in uno studio fiammingo a Gand. Il tedesco svizzero è abbastanza distinto dall'Hochdeutsch da mettere in difficoltà molti sistemi di riconoscimento vocale. Il catalano, parlato da milioni di persone in Spagna e Francia, viene spesso trattato come un caso limite dai fornitori il cui mercato principale è lo spagnolo castigliano. Una revisione narrativa del Centro ADAPT della Dublin City University identifica la variazione dialettale come una delle sfide centrali ancora irrisolte nella tecnologia linguistica basata sull'intelligenza artificiale per l'assistenza sanitaria, osservando che i guadagni di efficienza possono nascondere errori, ridurre la tracciabilità e spostare la responsabilità tra clinici e sistemi sanitari.
Il parlato accentato dei parlanti non nativi pone una sfida correlata ma distinta. Un medico di base di origine rumena che esercita in Irlanda e documenta in inglese può scoprire che l'accuratezza del riconoscimento vocale è significativamente inferiore rispetto a un madrelingua inglese che usa lo stesso strumento. Questo ha implicazioni dirette per gli studi con clinici formati all'estero, che rappresentano una quota significativa della forza lavoro nell'Unione Europea e nel Regno Unito.
Il code-switching, cioè il passaggio tra due o più lingue all'interno di una singola conversazione, è prassi comune negli ambienti clinici multilingue, eppure rimane uno degli scenari gestiti peggio. Un clinico in Lussemburgo può documentare in francese usando termini anatomici latini, nomi di farmaci inglesi e qualche frase in tedesco. Per la maggior parte degli strumenti attuali, il code-switching tra una lingua ben dotata di risorse e una con risorse insufficienti produce uno di due tipi di fallimento: lo strumento passa completamente alla lingua dominante e perde il contenuto nella lingua minoritaria, oppure tenta di trascrivere entrambe le lingue e introduce errori sistematici nei punti di transizione. Entrambi gli esiti sono inaccettabili in un contesto di documentazione clinica, dove informazioni mancanti o distorte possono influenzare direttamente la sicurezza del paziente.
La documentazione multilingue non è un problema di traduzione
Un'ipotesi comune è che uno strumento debba semplicemente convertire i termini pronunciati in una lingua nei loro equivalenti inglesi prima di applicare la codifica clinica standard. Il vocabolario medico, tuttavia, non è uniformemente standardizzato tra le lingue europee. Il Sistema di Nomenclatura Sistematizzata di Medicina, noto come SNOMED CT, dispone di traduzioni ufficiali in diverse lingue europee, ma la copertura è irregolare, e i clinici usano frequentemente termini informali o preferiti localmente che non si mappano direttamente ad alcun codice standardizzato.
Uno strumento addestrato su corpora clinici in inglese può riconoscere correttamente "heart failure" e mapparlo al codice SNOMED CT appropriato, ma non riuscire a fare la stessa cosa quando il termine viene pronunciato in polacco, greco o finlandese, anche se lo strumento dichiara di "supportare" quelle lingue. La ricerca sulle note bilingui in spagnolo e catalano ha rilevato che la messa a punto con dati di addestramento bilingui combinati, anziché dati specifici per una sola lingua, generalizza meglio in modo costante: un risultato che ha implicazioni dirette per qualsiasi studio che valuti strumenti di documentazione in lingue europee non inglesi.
Come valutare uno strumento prima di implementarlo in uno studio multilingue
I clinici e i responsabili degli studi dovrebbero andare oltre le affermazioni di marketing e porre domande specifiche e verificabili. Quattro aree meritano attenzione sistematica.
La prima riguarda i dati di validazione specifici per lingua: in quali lingue lo strumento è stato validato e su quale dataset? La validazione è avvenuta su parlato clinico reale o su registrazioni pulite in studio? Qual era il tasso di errore delle parole per il riconoscimento vocale nella lingua target e come si confronta con le prestazioni in inglese?
La seconda riguarda la copertura di dialetti e accenti. Lo strumento è stato testato sulla varietà regionale specifica usata nel vostro studio, come l'olandese fiammingo, il tedesco svizzero o il catalano? Qual è la differenza di prestazioni documentata tra la varietà standard e quella regionale?
La terza area è la gestione del code-switching: come si comporta lo strumento quando i termini medici vengono pronunciati in latino o in inglese all'interno di una consultazione non inglese? La capacità di gestire il code-switching è descritta solo qualitativamente o è supportata da dati di accuratezza misurati?
La quarta, e spesso trascurata, è l'accuratezza della codifica clinica considerata separatamente dalla trascrizione. Uno strumento può raggiungere un'accuratezza di trascrizione accettabile pur non riuscendo a generare codici SNOMED CT o ICD corretti nella lingua target. Richiedete dati sull'accuratezza della codifica specifici per la vostra lingua e contesto clinico.
I segnali d'allarme più comuni: il fornitore cita solo studi di validazione in lingua inglese; le cifre di accuratezza vengono presentate come un numero unico per tutte le lingue supportate; la validazione è avvenuta su registrazioni pulite piuttosto che su parlato clinico reale; le prestazioni su dialetti regionali o in situazioni di code-switching vengono descritte qualitativamente anziché con dati misurati. Il commento del 2025 sugli scribe basati sull'intelligenza artificiale in ambito sanitario osserva che la maggior parte delle valutazioni esistenti proviene da studi pilota su piccola scala e a breve termine, condotti con partecipanti già orientati verso la tecnologia. Questa limitazione vale con ancora maggiore forza per le valutazioni in lingue non inglesi, dove la base di evidenze è ancora più ridotta.
Conformità al GDPR per gli strumenti che elaborano audio in lingue diverse
Il Regolamento generale sulla protezione dei dati (GDPR) si applica a tutti i dati personali trattati all'interno dell'Unione Europea, indipendentemente dalla lingua in cui sono stati parlati o registrati. Le registrazioni audio delle consultazioni cliniche in qualsiasi lingua costituiscono dati sanitari sensibili ai sensi dell'articolo 9 del GDPR e sono soggette all'intera gamma di obblighi di protezione dei dati.
Gli studi dovrebbero verificare tre aspetti specifici. Primo, dove vengono elaborati i dati audio: alcuni strumenti inviano l'audio verso infrastrutture cloud al di fuori dell'UE per la trascrizione, e i trasferimenti al di fuori dello Spazio economico europeo richiedono garanzie adeguate ai sensi del Capo V del GDPR. Secondo, se la documentazione sulla privacy del fornitore copre tutte le lingue supportate: gli strumenti che elaborano audio non inglese attraverso infrastrutture diverse possono avere posizioni di archiviazione dei dati incoerenti. Terzo, lo stato rispetto al Regolamento sui dispositivi medici: gli strumenti che generano output clinici possono qualificarsi come dispositivi medici ai sensi della normativa UE, con implicazioni per quali lingue e contesti clinici sono stati formalmente validati.
Cosa deve cambiare perché questi strumenti siano affidabili in Europa
Il divario nelle prestazioni multilingue non è un problema irrisolvibile, ma la comunità di ricerca e i fornitori commerciali lo affrontano ancora in modo insufficiente. Sono necessari tre cambiamenti.
Il più urgente è la costruzione di dataset clinicamente validati in lingue sottorappresentate, polacco, rumeno, greco, olandese e altre. Il predominio dei dati in lingua inglese nei corpora di addestramento riflette priorità storiche di ricerca e commerciali, non la distribuzione reale dell'attività clinica in Europa. La revisione del Centro ADAPT del 2026 sostiene che questo richiede non solo modelli migliori, ma anche una progettazione sociotecnica responsabile e una collaborazione più stretta tra l'elaborazione del linguaggio naturale, la pratica clinica e le istituzioni che definiscono le politiche.
Il secondo cambiamento necessario riguarda i modelli in grado di riconoscere i dialetti. Le varietà linguistiche standard non costituiscono una base sufficiente per la validazione dell'intelligenza artificiale clinica: i modelli devono essere testati e, dove necessario, messi a punto sulle varietà regionali effettivamente usate nella pratica, tra cui l'olandese fiammingo, il tedesco svizzero, il catalano e gli accenti francesi regionali.
Il terzo è la validazione clinica come requisito normativo. Il documento politico del BMJ chiede che le politiche basate sull'evidenza obblighino gli strumenti linguistici basati sull'intelligenza artificiale in ambito sanitario a dimostrare la sicurezza clinica nelle lingue e nei contesti in cui vengono implementati. Senza questa pressione normativa, i fornitori hanno pochi incentivi commerciali a investire nella validazione per mercati linguistici più piccoli, e quella pressione, al momento, non esiste.
Per i clinici che operano oggi in ambienti europei multilingue, il supporto linguistico elencato sul sito web di un fornitore non equivale a prestazioni cliniche validate. Applicare con rigore le domande e i criteri di valutazione descritti sopra, prima di qualsiasi implementazione, è la protezione più affidabile contro gli errori cumulativi che gli strumenti di documentazione basati sull'intelligenza artificiale multilingue possono introdurre nei sistemi di cartelle cliniche.
Domande frequenti
▶ Perché gli strumenti di documentazione basati sull'intelligenza artificiale hanno prestazioni diverse tra le lingue europee
Lo squilibrio nei dati di addestramento è la causa strutturale, ma il problema si manifesta in due punti distinti: nella trascrizione e nella generazione della nota. Un errore nel primo strato si propaga al secondo, producendo note clinicamente plausibili ma inesatte. Verificare l'accuratezza in entrambi gli strati separatamente è più utile che valutare lo strumento come un sistema unico.
▶ Quali lingue europee sono meglio e meno supportate dagli strumenti di documentazione basati sull'intelligenza artificiale clinica
L'inglese è la lingua meglio supportata con un margine sostanziale. Spagnolo, francese e tedesco hanno una rappresentanza ragionevole, sebbene con lacune nel vocabolario clinico. Olandese, portoghese e italiano hanno un supporto moderato. Le lingue tipicamente sottorappresentate includono polacco, rumeno, greco, ceco, ungherese, finlandese, catalano, gallese e maltese. I clinici che operano in queste lingue dovrebbero verificare in modo indipendente l'accuratezza di base piuttosto che darla per scontata.
▶ Quali errori di documentazione specifici dovrebbero aspettarsi i clinici con le lingue germaniche e slave
In tedesco e olandese il rischio principale riguarda i sostantivi composti: uno strumento che segmenta Herzinsuffizienz può produrre una nota priva della diagnosi corretta. Nelle lingue slave il problema è la flessione: lo stesso termine clinico può comparire in sei o più forme, e un modello con esposizione insufficiente le tratta come concetti distinti, generando omissioni ripetute nella stessa consultazione.
▶ Il dialetto e il parlato accentato influenzano l'accuratezza della documentazione basata sull'intelligenza artificiale
Sì. La variazione dialettale riduce l'accuratezza anche all'interno di una lingua ufficialmente supportata. Il problema pratico per gli studi con clinici formati all'estero, una quota significativa della forza lavoro nell'UE e nel Regno Unito, è che il parlato accentato abbassa la qualità della trascrizione in modo sistematico, e questa perdita raramente viene quantificata nelle schede tecniche dei fornitori.
▶ Come gestiscono gli strumenti di documentazione basati sull'intelligenza artificiale il code-switching, quando i clinici mescolano le lingue durante la consultazione
Gli strumenti attuali producono due tipi di errore: perdita del contenuto nella lingua minoritaria oppure errori sistematici nei punti di transizione. In entrambi i casi il risultato è una nota incompleta o inesatta. Prima di adottare uno strumento in un contesto multilingue, chiedere al fornitore dati di accuratezza misurati sul code-switching, non solo una descrizione qualitativa della funzionalità.
▶ La documentazione clinica multilingue è solo un problema di traduzione
No. La ricerca sulle note bilingui in spagnolo e catalano ha mostrato che la messa a punto con dati di addestramento bilingui combinati generalizza meglio rispetto a modelli addestrati su una sola lingua. Questo suggerisce che il problema non è la traduzione termine per termine, ma la struttura stessa del corpus su cui il modello è stato addestrato.
▶ Quali domande dovrebbero porre i clinici ai fornitori quando valutano uno strumento di documentazione basato sull'intelligenza artificiale per uno studio multilingue
Quattro domande concrete: il tasso di errore delle parole nella lingua target rispetto all'inglese; se la validazione è avvenuta su parlato clinico reale o su registrazioni pulite; le prestazioni documentate sulla varietà regionale specifica dello studio; l'accuratezza della codifica SNOMED CT o ICD nella lingua target, misurata separatamente dalla trascrizione.
▶ Quali sono le implicazioni del Regolamento generale sulla protezione dei dati nell'uso di strumenti di documentazione basati sull'intelligenza artificiale che elaborano audio non inglese
Le registrazioni audio in qualsiasi lingua sono dati sanitari sensibili ai sensi dell'articolo 9 del GDPR. Un aspetto spesso trascurato: gli strumenti che elaborano audio non inglese attraverso infrastrutture diverse rispetto all'audio inglese possono avere posizioni di residenza dei dati incoerenti, rendendo più difficile verificare la conformità al Capo V per i trasferimenti fuori dallo Spazio economico europeo.
▶ Quali benchmark di accuratezza indicano che uno strumento di documentazione basato sull'intelligenza artificiale è adatto per l'uso clinico in una lingua non inglese
Tre soglie minime da richiedere: tasso di errore delle parole inferiore al 10-15% per la lingua e il dialetto specifici, accuratezza del riconoscimento della terminologia diagnostica superiore all'80% nella lingua target, accuratezza della codifica ICD o SNOMED paragonabile a quella dello stesso strumento in inglese. Se il fornitore presenta un'unica cifra aggregata per tutte le lingue supportate, i dati non sono sufficienti per una valutazione affidabile.
▶ Quali cambiamenti sono necessari prima che gli strumenti di documentazione basati sull'intelligenza artificiale possano essere considerati affidabilmente sicuri nell'assistenza primaria europea multilingue
Tre requisiti: dataset clinicamente validati in lingue sottorappresentate, modelli testati sulle varietà regionali effettivamente usate nella pratica e validazione clinica come obbligo normativo. La revisione del Centro ADAPT del 2026 sottolinea che questo richiede collaborazione tra elaborazione del linguaggio naturale, pratica clinica e istituzioni regolatorie, non solo modelli tecnicamente più avanzati.