13
min de lecture
Outils de documentation IA dans les langues européennes
Pourquoi les outils de documentation IA fonctionnent différemment selon les langues européennes en soins primaires. Validation linguistique, variations dialectales et défis du codage médical expliqués
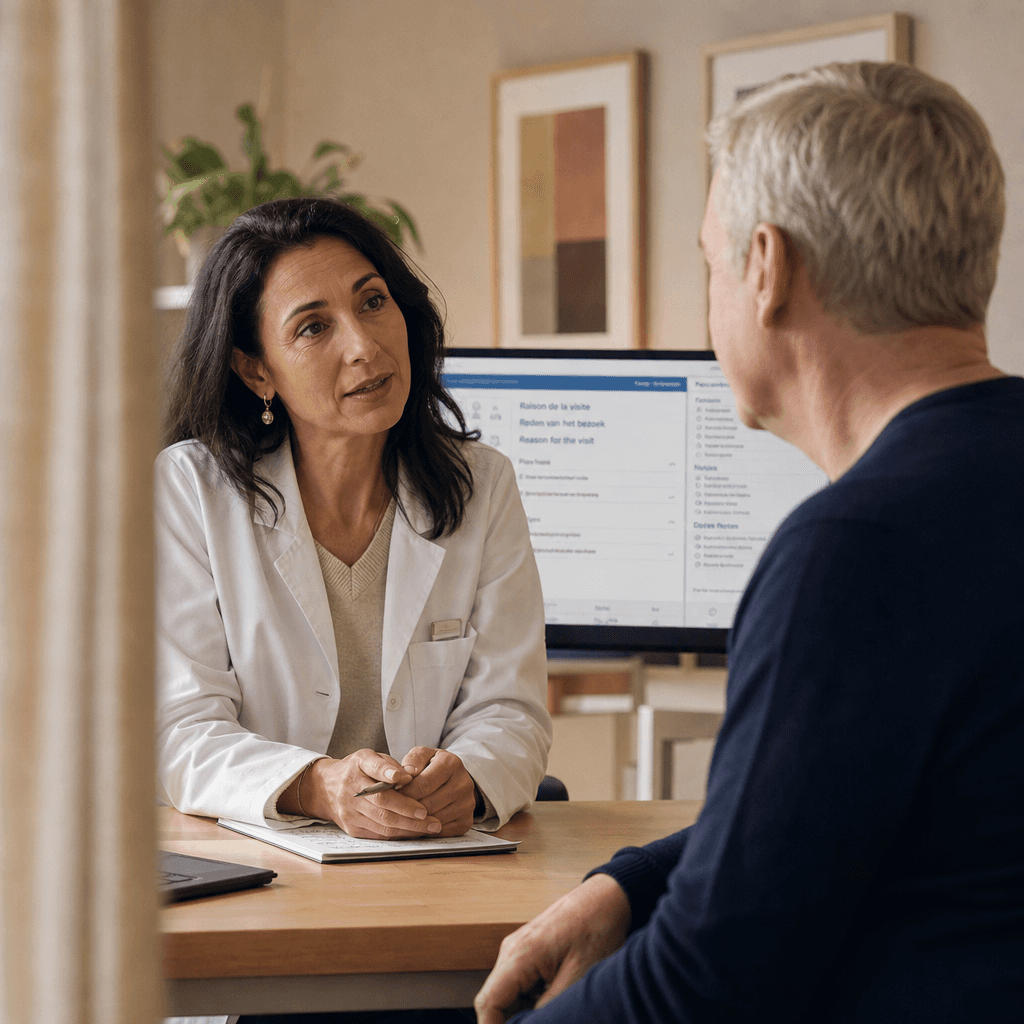
Les outils de documentation par intelligence artificielle (IA) peinent à suivre la réalité linguistique des soins primaires européens — et ces écarts de performance ne sont pas de simples désagréments techniques. Ils représentent des risques concrets pour la sécurité des patients.
Les outils de documentation par intelligence artificielle peinent à suivre la réalité linguistique des soins primaires européens. Ces écarts de performance ne sont pas de simples désagréments techniques : ils représentent des risques concrets pour la sécurité des patients.
Pourquoi certaines langues européennes sont mieux prises en charge que d'autres
La plupart des outils de documentation IA utilisés en soins primaires combinent deux composants. La reconnaissance vocale automatique (RVA) convertit les mots parlés en texte. Un grand modèle de langage (GML) ou une couche de traitement automatique du langage naturel (TALN) transforme ensuite ce texte en documentation médicale structurée. Les erreurs se cumulent à travers ces deux couches : si la RVA interprète mal un terme médical prononcé avec un accent régional, le GML reçoit une entrée erronée et peut générer une note plausible mais cliniquement incorrecte.
Les disparités entre langues s'expliquent avant tout par le déséquilibre des données d'entraînement. Un modèle exposé à des milliards de documents médicaux en anglais, mais seulement à des millions — voire des centaines de milliers — de textes équivalents en néerlandais, roumain ou grec sera structurellement moins performant dans ces langues. Une étude publiée dans Scientific Reports en 2025 a mis en évidence les défis que posent la richesse morphologique, la variation syntaxique et la diglossie pour les GML dans les tâches médicales. La diglossie désigne la coexistence de deux variétés d'une même langue au sein d'une communauté. Ces défis touchent particulièrement les langues sous-représentées.
En pratique, l'anglais bénéficie d'une nette avance. L'espagnol, le français et l'allemand sont raisonnablement bien couverts, avec des lacunes dans le vocabulaire médical. Le néerlandais, le portugais et l'italien disposent d'un support modéré. Le polonais, le roumain, le grec, le tchèque, le hongrois, le finnois, le catalan, le gallois et le maltais restent généralement sous-représentés. Les cliniciens qui exercent dans ces langues doivent vérifier la précision de base de façon indépendante, sans la tenir pour acquise.
Modes de défaillance prévisibles selon les familles linguistiques
En allemand et en néerlandais, les outils IA reconnaissent souvent mal les noms composés. Un terme comme Herzinsuffizienz (insuffisance cardiaque) ou Bluthochdruck (hypertension) doit être reconnu comme une entité clinique unique. Les outils insuffisamment entraînés sur des textes médicaux allemands segmentent ou reconnaissent souvent mal ces composés, et génèrent alors des notes qui omettent ou déforment le diagnostic.
Les langues romanes attribuent un genre grammatical à la terminologie médicale, et le sens clinique peut changer en cas d'erreur d'accord. La variation régionale du vocabulaire est également significative : la même affection peut être désignée par des termes différents en France et en Belgique, ou en Espagne et en Amérique latine. Une étude portant sur des notes de soins primaires bilingues en espagnol et catalan a montré que la reconnaissance conjointe des diagnostics et leur association aux codes de la Classification internationale des maladies (CIM-10) dans des notes bilingues non standard constituent un problème particulièrement complexe.
Le polonais et le tchèque sont morphologiquement complexes : un terme médical peut apparaître sous six formes ou plus au cours d'une seule consultation. Un modèle sans exposition suffisante à cette variation flexionnelle ne reconnaîtra pas de manière cohérente le même concept clinique à travers ses différentes formes. Les évaluations multilingues de la fiabilité des GML dans les soins de santé identifient ce manque d'évaluation comme un obstacle majeur à l'adoption en pratique réelle. Le référentiel cité couvre 15 langues sans inclure le polonais, le tchèque ni le slovaque.
Dialectes, accents et alternance codique
Même au sein d'une langue officiellement prise en charge, la variation dialectale peut considérablement dégrader la précision. Un outil validé pour le néerlandais standard peut être nettement moins performant dans un cabinet flamand à Gand. Le suisse allemand est suffisamment distinct du Hochdeutsch pour que de nombreux systèmes de RVA ne parviennent pas à le transcrire de façon fiable. Une revue narrative du Centre ADAPT de la Dublin City University pointe ce point comme l'un des défis centraux non résolus : produire des résultats corrects dans une variété standard ne garantit pas une performance acceptable sur l'ensemble du continuum dialectal. La revue souligne également que les gains d'efficacité des outils IA peuvent masquer les erreurs, réduire la traçabilité et déplacer la responsabilité entre cliniciens et systèmes de santé, des risques qui s'amplifient quand la variation dialectale n'est pas prise en compte lors de la validation.
Le discours accentué des locuteurs non natifs pose un défi connexe mais distinct. Un médecin généraliste né en Roumanie, exerçant en Irlande et documentant en anglais, peut constater que la précision de la RVA est nettement inférieure à celle d'un locuteur natif utilisant le même outil. C'est une réalité directement pertinente pour les cabinets qui emploient des cliniciens formés à l'international, lesquels représentent une part significative des effectifs de soins primaires dans l'Union européenne (UE) et au Royaume-Uni.
L'alternance codique, c'est-à-dire le passage entre deux langues ou plus au sein d'une même consultation, reste l'un des scénarios les plus mal gérés. Un clinicien au Luxembourg peut documenter en français tout en utilisant des termes anatomiques latins, des noms de médicaments anglais et quelques phrases en allemand. Pour la plupart des outils actuels, cela produit l'un de deux modes de défaillance : soit l'outil bascule entièrement vers la langue dominante et ignore le contenu dans la langue minoritaire, soit il tente de transcrire les deux mais introduit des erreurs systématiques aux points de transition. Dans un contexte de documentation médicale, où les informations manquantes ou déformées peuvent compromettre directement la sécurité des patients, aucun de ces résultats n'est acceptable.
La documentation multilingue n'est pas un problème de traduction
Une idée répandue est qu'un outil IA devrait simplement faire correspondre les termes parlés dans une langue à leurs équivalents anglais avant d'appliquer le codage médical standard. Cette hypothèse est erronée, pour des raisons qui tiennent à la structure même du vocabulaire médical européen.
SNOMED CT, le système de terminologie médicale le plus largement utilisé, dispose de traductions officielles dans plusieurs langues européennes, mais la couverture reste inégale. En pratique, les cliniciens utilisent fréquemment des termes informels, abrégés ou localement préférés qui ne correspondent pas directement à un code standardisé. Un outil entraîné sur des corpus médicaux anglais peut reconnaître correctement « heart failure » et l'associer au code SNOMED CT approprié, mais échouer à effectuer le même mappage quand le terme est prononcé en polonais, en grec ou en finnois, même si l'outil prend nominalement en charge ces langues.
L'étude sur le codage CIM-10 dans les notes bilingues en espagnol et catalan a montré que les formats non standard et le mélange bilingue créent des défis spécifiques qui ne peuvent pas être résolus en appliquant des modèles entraînés sur des corpus monolingues standard. Ce sont les données d'entraînement bilingues combinées, plutôt que les données propres à une seule langue, qui ont le mieux généralisé. Cette conclusion a des implications directes pour les cabinets qui évaluent des outils dans toute langue européenne non anglaise.
Comment évaluer la performance linguistique d'un outil avant de le déployer
Les cliniciens et gestionnaires de cabinet qui évaluent des outils pour des environnements multilingues doivent aller au-delà des arguments marketing et poser des questions précises et vérifiables.
Sur les données de validation : dans quelles langues l'outil a-t-il été validé, et sur quel ensemble de données ? La validation a-t-elle été réalisée sur de la parole médicale réelle ou sur des enregistrements de studio propres ? Quel était le taux d'erreur de mots, c'est-à-dire la proportion de mots mal transcrits, pour la RVA dans la langue cible, et comment se compare-t-il aux performances en anglais sur le même outil ?
Sur les dialectes et les accents : l'outil a-t-il été testé sur la variété régionale spécifique utilisée dans votre cabinet, qu'il s'agisse du néerlandais flamand, du suisse allemand ou du catalan ? Quelle est la différence de performance documentée entre les variétés standard et régionales ?
Sur le codage médical : un outil peut atteindre une précision de transcription acceptable tout en échouant à générer des codes SNOMED CT ou CIM corrects dans la langue cible. Des données de précision de codage médical spécifiques à la langue et au contexte clinique doivent être demandées explicitement.
La base de preuves disponible pour guider ces choix reste mince. Le commentaire de 2025 sur les scribes médicaux IA dans les soins de santé souligne que la plupart des évaluations existantes s'appuient sur des études pilotes à petite échelle et de courte durée, menées avec des participants déjà sensibilisés à la technologie. Cette limite vaut tout particulièrement pour les langues non anglaises. Le protocole d'étude EuropeMedQA (actuellement un préprint) propose un premier cadre structuré pour comparer les performances des GML en italien, français, espagnol et portugais, mais la performance sur des questions d'examen standardisées ne prédit pas nécessairement la performance sur la parole médicale réelle, et quatre langues couvrent encore une fraction limitée du paysage européen.
Certains signaux d'alarme sont bien identifiables. Le fournisseur ne cite que des études de validation en anglais et décrit la prise en charge d'autres langues comme « à venir » ou « en version bêta ». Les chiffres de précision sont présentés comme une valeur unique pour toutes les langues prises en charge. La performance sur les dialectes ou l'alternance codique est décrite de façon qualitative plutôt que soutenue par des données chiffrées.
Conformité au RGPD et statut réglementaire pour les outils multilingues dans l'UE
Le Règlement général sur la protection des données (RGPD) s'applique à toutes les données personnelles traitées au sein de l'UE, quelle que soit la langue dans laquelle elles ont été parlées ou enregistrées. Les enregistrements audio de consultations médicales, qu'ils soient en polonais, en roumain, en arabe ou dans toute autre langue, constituent des données de santé sensibles au sens de l'article 9 du RGPD et sont donc soumis à l'ensemble des obligations de protection des données.
Les cabinets doivent vérifier où les données audio sont traitées et stockées : certains outils acheminent l'audio vers une infrastructure cloud hors UE pour la transcription. Le RGPD n'impose pas d'hébergement strict au sein de l'UE, mais tout transfert hors de l'Espace économique européen (EEE) doit s'accompagner des garanties appropriées prévues au chapitre V. Un point d'attention spécifique mérite d'être soulevé ici : les outils qui traitent l'audio non anglais via une infrastructure différente de celle de l'audio anglais peuvent présenter des politiques d'hébergement des données incohérentes, une asymétrie que peu de fournisseurs documentent explicitement. Par ailleurs, les outils de documentation IA qui génèrent des résultats médicaux peuvent être qualifiés de dispositifs médicaux au sens du Règlement sur les dispositifs médicaux (RDM), ce qui a des implications directes pour les langues et les contextes cliniques ayant fait l'objet d'une validation formelle.
Ce qui doit changer pour que ces outils soient réellement fiables
L'écart de performance multilingue n'est pas insoluble, mais il reste actuellement sous-estimé. Trois évolutions sont nécessaires.
La première est la constitution d'ensembles de données d'entraînement plus diversifiés. La domination de l'anglais dans les corpus d'entraînement reflète des priorités historiques de recherche et commerciales, et non la réalité de l'activité médicale en Europe. La revue 2026 du Centre ADAPT soutient que cela nécessite non seulement de meilleurs modèles, mais aussi une conception sociotechnique responsable et une collaboration renforcée entre le traitement automatique du langage naturel, la pratique clinique et les décideurs politiques.
La deuxième est le développement de modèles sensibles aux dialectes. Les variétés standard sont insuffisantes comme base de validation. Les modèles doivent être testés et, si nécessaire, ajustés sur les variétés régionales réellement utilisées en pratique clinique : néerlandais flamand, suisse allemand, catalan, accents régionaux français, et les nombreuses autres variétés qui composent le paysage linguistique réel des soins primaires européens.
La troisième est la validation clinique comme exigence réglementaire. Le document de politique du BMJ appelle à des cadres fondés sur des preuves, qui obligent les fournisseurs d'outils de langage IA en santé à démontrer leur sécurité clinique dans chaque langue et chaque contexte où ils sont déployés. Sans pression réglementaire, aucun fournisseur n'a d'incitation commerciale sérieuse à investir dans la validation pour les marchés linguistiques plus restreints. Les données d'entraînement et les modèles dialectaux peuvent s'améliorer progressivement, mais c'est l'exigence réglementaire qui fixe le plancher en dessous duquel aucun outil ne devrait pouvoir être déployé.
Pour les cliniciens qui exercent aujourd'hui dans des environnements multilingues, la conclusion pratique est directe : la prise en charge linguistique affichée sur le site web d'un fournisseur ne vaut pas une performance clinique validée. Les questions à poser, les repères à demander et les signaux d'alarme à surveiller sont bien définis, et les appliquer rigoureusement avant le déploiement reste la meilleure protection contre les erreurs cumulatives que les outils de documentation IA multilingues peuvent introduire dans les dossiers médicaux.
Questions fréquemment posées
▶ Pourquoi les outils de documentation IA fonctionnent-ils différemment selon les langues européennes ?
Le déséquilibre des données d'entraînement en est la cause principale. Un modèle exposé à des milliards de documents médicaux en anglais mais à seulement des centaines de milliers en roumain ou en grec sera structurellement moins performant dans ces langues, et les erreurs se cumulent à travers les deux couches du système, transcription puis structuration.
▶ Quelles langues européennes sont les mieux et les moins bien prises en charge par les outils de documentation médicale IA ?
L'anglais domine, suivi de l'espagnol, du français et de l'allemand avec des lacunes médicales, puis du néerlandais, du portugais et de l'italien. Le polonais, le roumain, le grec, le tchèque, le hongrois, le finnois, le catalan, le gallois et le maltais restent sous-représentés. Dans ces langues, vérifier la précision de base de façon indépendante est indispensable avant tout déploiement.
▶ Quelles erreurs de documentation spécifiques les cliniciens doivent-ils anticiper avec les langues germaniques et slaves ?
En allemand et en néerlandais, les noms composés comme Herzinsuffizienz sont souvent segmentés ou omis. En polonais et en tchèque, un même terme médical peut prendre six formes flexionnelles ou plus lors d'une consultation. Demandez au fournisseur des données de précision spécifiques à chaque forme, pas seulement au lemme de base.
▶ Le dialecte et le discours accentué affectent-ils la précision de la documentation IA ?
Oui. La validation sur une variété standard ne garantit pas une performance acceptable sur l'ensemble du continuum dialectal. Avant de déployer un outil, demandez des chiffres de précision mesurés sur la variété régionale précise de votre cabinet, par exemple le néerlandais flamand ou le suisse allemand, et non sur la variété standard utilisée lors de la validation initiale.
▶ Comment les outils de documentation IA gèrent-ils l'alternance codique, lorsque les cliniciens mélangent les langues en pleine consultation ?
La plupart des outils actuels échouent dans ce scénario. Ils basculent entièrement vers la langue dominante et ignorent le contenu dans la langue minoritaire, ou introduisent des erreurs systématiques aux points de transition. Aucun de ces résultats n'est acceptable en documentation médicale, où les informations manquantes peuvent compromettre la sécurité des patients.
▶ La documentation médicale multilingue est-elle simplement un problème de traduction ?
Non. Les cliniciens utilisent fréquemment des termes informels ou localement préférés qui ne correspondent à aucun code standardisé. La recherche sur les notes bilingues espagnol-catalan a montré que des données d'entraînement bilingues combinées généralisent mieux que des modèles monolingues, ce qui a des implications directes pour tout cabinet évaluant un outil dans une langue européenne non anglaise.
▶ Quelles questions les cliniciens devraient-ils poser aux fournisseurs lors de l'évaluation d'un outil de documentation IA pour un cabinet multilingue ?
Demandez le taux d'erreur de mots pour la langue et le dialecte cibles comparé à l'anglais sur le même outil, les résultats de tests sur votre variété régionale spécifique, et des données de précision de codage médical dans votre langue. Un outil peut transcrire correctement tout en générant des codes SNOMED CT ou CIM erronés.
▶ Quelles sont les implications du RGPD concernant l'utilisation d'outils de documentation IA qui traitent l'audio non anglais ?
Les enregistrements audio de consultations médicales dans toute langue relèvent de l'article 9 du RGPD. Un point souvent négligé : certains fournisseurs acheminent l'audio non anglais vers une infrastructure différente de celle de l'audio anglais, ce qui peut créer des asymétries dans les politiques d'hébergement des données que peu de fournisseurs documentent explicitement.
▶ Quels repères de précision indiquent qu'un outil de documentation IA est adapté à l'utilisation clinique dans une langue non anglaise ?
Trois seuils minimaux : taux d'erreur de mots inférieur à 10 à 15 % pour la langue et le dialecte utilisés, précision de reconnaissance des termes diagnostiques courants supérieure à 80 % dans la langue cible, et précision de codage CIM ou SNOMED comparable à celle obtenue par le même outil en anglais. Tout chiffre présenté comme valeur unique pour toutes les langues est un signal d'alarme.
▶ Quels changements sont nécessaires avant que les outils de documentation IA puissent être considérés comme fiables et sûrs à travers les soins primaires européens multilingues ?
Trois leviers sont nécessaires : des corpus d'entraînement plus diversifiés dans les langues sous-représentées, des modèles testés sur les variétés régionales réellement utilisées en pratique, et une exigence réglementaire de validation clinique par langue et par contexte. Sans cette dernière, les fournisseurs n'ont aucune incitation commerciale sérieuse à investir dans les marchés linguistiques plus restreints.